Мощность целой команды внутри периметра
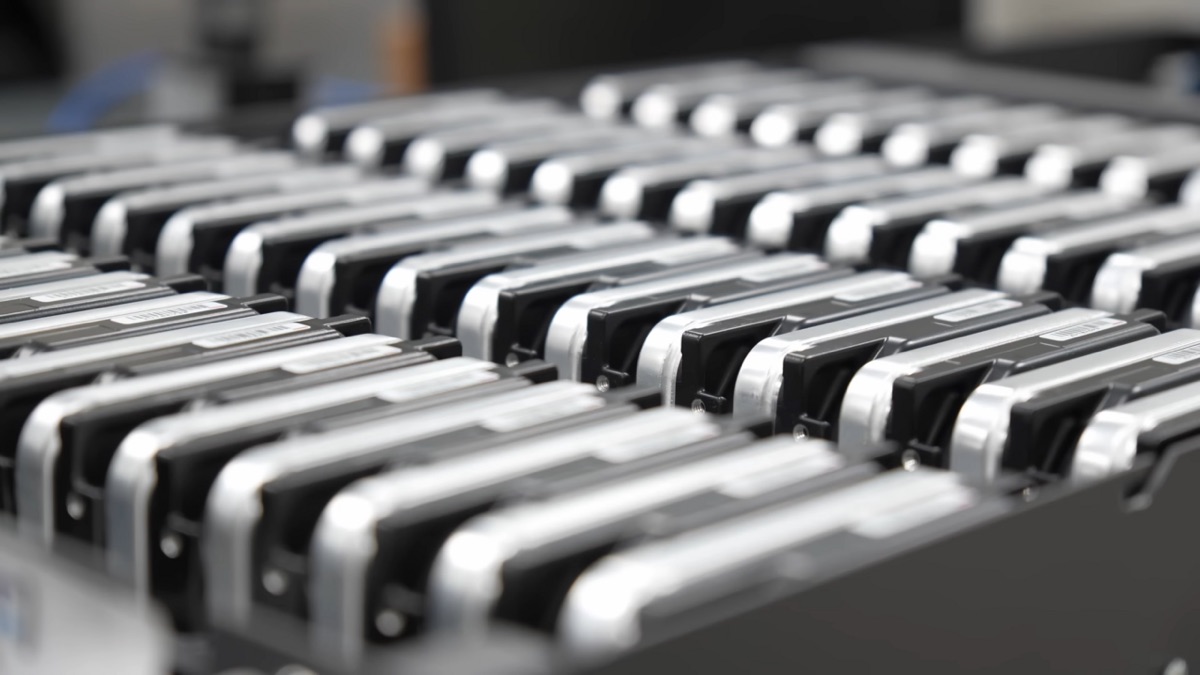
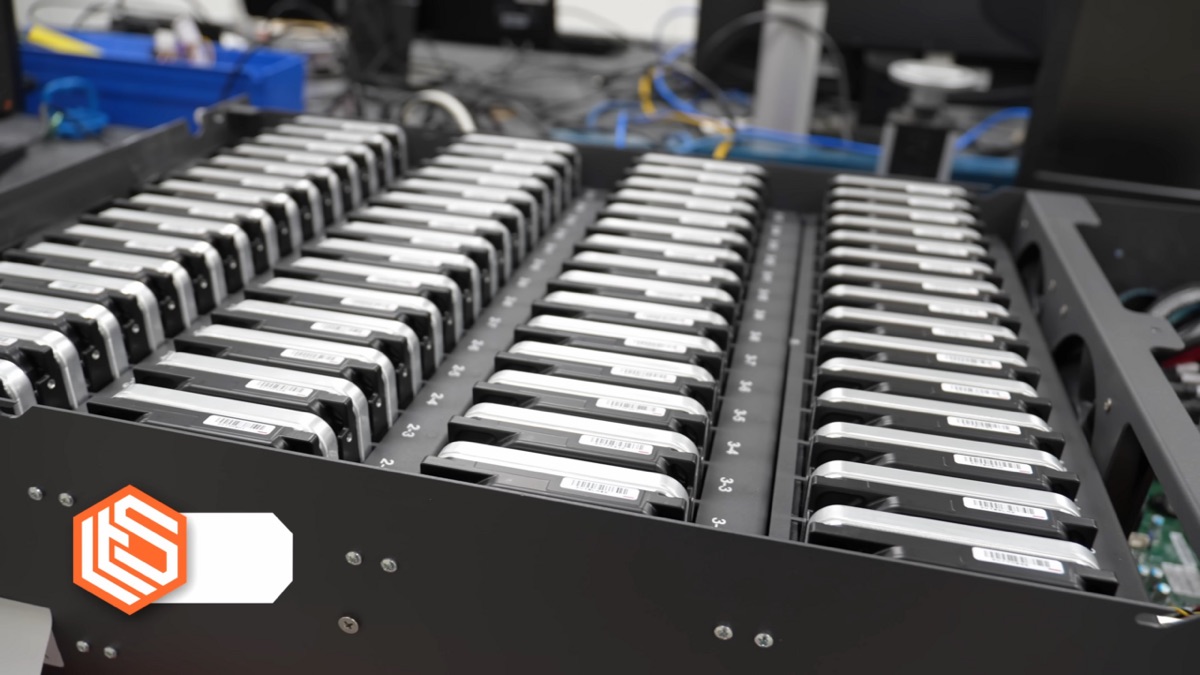
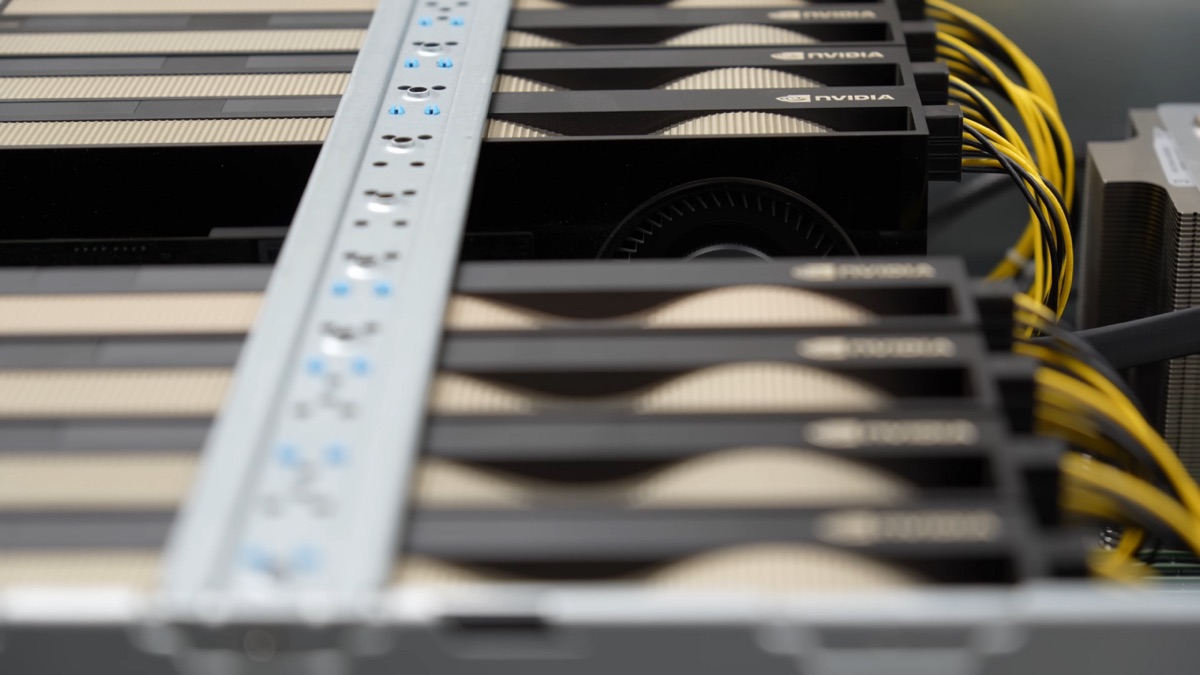
Референсная конфигурация: четыре RTX 4090 и 96 ГБ VRAM тянут локальные модели до 70B и обслуживают 10–40 разработчиков в параллель. Жидкостное охлаждение и резервное питание — для круглосуточной нагрузки.
Включает ПО, пусконаладку и 24 мес. поддержки + SLA. Не является публичной офертой.
Что тянет PRO
Ориентировочная пропускная способность инференса (оценка, зависит от модели, квантизации и длины контекста). Финальные цифры подтверждаем на демо на вашем сценарии.
ток/с · модель 70B (Q4)
Ревью и генерация с полным контекстом репозитория на топовой локальной модели.
ток/с · модель 34B (Q4)
Рабочий баланс скорости и качества для повседневного автодополнения и ассистента.
параллельных сессий
Одновременная работа команды через единый OpenAI‑совместимый эндпоинт.
Полная спецификация PRO
Что входит в поставку
- Собранная и протестированная машинаПрогон под нагрузкой, проверка совместимости с AI‑SDLC
- Предустановленные open‑weight моделиQwen, Llama, DeepSeek и совместимые под 96 ГБ VRAM
- SDLC‑AI OS + Memory‑Bank runtimeИнференс‑сервер, веб‑консоль, RBAC, аудит‑лог
- Пусконаладка на площадкеРазвёртывание в вашей сети, настройка эндпоинта и IDE
- Подготовка к аттестацииПомощь с требованиями 152‑ФЗ и ФСТЭК
- Поддержка 24 мес. + SLAОбновления моделей на защищённом носителе
PRO — для продуктовой команды
Отделы разработки на 10–40 человек в госсекторе, финтехе и R&D, которым нужна облачная продуктивность ИИ без единого исходящего запроса. Air‑gap режим, RBAC и аудит закрывают требования безопасности.
Сравнить линейку
Запросите демо SDLC‑BOX PRO
Покажем работу закрытого контура на вашем сценарии и подготовим КП под ваше ТЗ.
Оставить заявку